의도와 다른 입력
조작된 요청이나 참조 문서의 지시가 서비스의 원래 목적을 바꿀 가능성을 살펴봅니다.
AI 모델·서비스 보안 검증
AI 서비스의 보안 경계를 검토합니다.
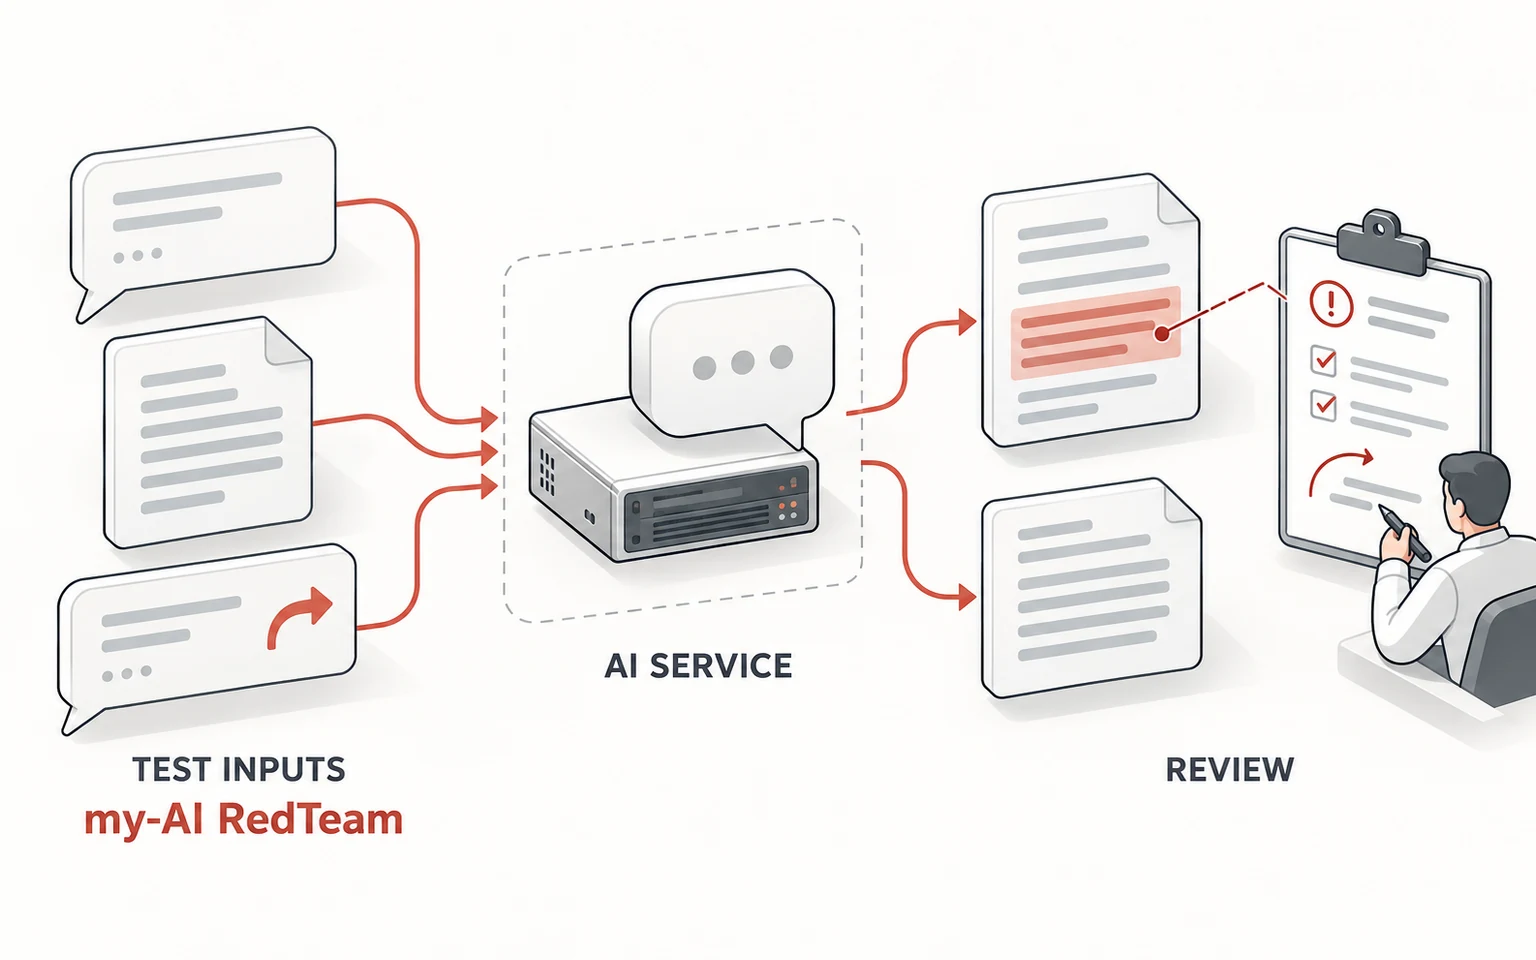
AI 모델과 서비스가 다양한 입력과 사용 상황에서 드러낼 수 있는 보안 위험을 점검하는 솔루션입니다.
 이미지 크게 보기
점검 관점 예시 · 적용 범위 협의
조작된 요청이나 참조 문서의 지시가 서비스의 원래 목적을 바꿀 가능성을 살펴봅니다.
응답에 포함될 수 있는 정보와 연결된 데이터·서비스의 접근 범위를 함께 고려합니다.
예상하지 못한 사용 상황에서도 응답이 조직의 운영 정책과 안전 기준에 부합하는지 검토합니다.
아래는 AI 레드티밍의 대표적인 검토 관점입니다. 실제 적용 항목과 지원 범위는 대상 환경에 맞춰 협의합니다.
사용자 입력이나 참조 문서에 포함된 지시가 서비스의 원래 목적을 바꾸거나, 허용되지 않은 응답·행동을 유도할 가능성을 검토합니다. 프롬프트 인젝션과 같은 위험을 이해하고 입력·출력 경계를 살펴보는 관점입니다.
개인정보나 내부 업무 정보가 응답에 포함될 가능성, 사용자에게 허용된 범위를 벗어난 정보가 제공될 가능성을 검토합니다. 모델의 답변뿐 아니라 연결된 데이터와 서비스의 접근통제도 함께 고려해야 합니다.
허용하지 않은 요청이나 변형된 질문에 대한 응답이 조직의 운영 정책과 안전 기준에 부합하는지 살펴봅니다. 정상 사용과 악용 가능성을 구분하고, 보호조치가 필요한 지점을 정리하는 데 목적이 있습니다.
점검 결과는 위험이 나타난 조건과 영향을 정리하고 개선 우선순위를 정하는 데 활용할 수 있습니다. 정책·권한·입출력 처리 등을 보완한 뒤 같은 조건을 다시 확인하여 개선 효과를 검토하는 것이 중요합니다.
검토하려는 AI 모델·서비스의 사용 목적과 대상 환경을 확인합니다.
대상에 필요한 검토 항목과 접근 조건을 살펴보고 적용 가능한 범위를 협의합니다.
위험이 나타난 조건과 개선 방향을 어떻게 정리하고 후속 확인에 활용할지 협의합니다.
대상 환경과 활용 목적을 바탕으로 적용 항목과 지원 범위를 상담합니다.