偏離原意的輸入
檢視經過操控的請求或參考文件中的指示,是否可能改變服務的原定目的。

AI 模型與服務安全驗證
檢視 AI 服務的 安全邊界。
在多種輸入與使用場景下,驗證 AI 模型和服務可能表現出的安全風險。
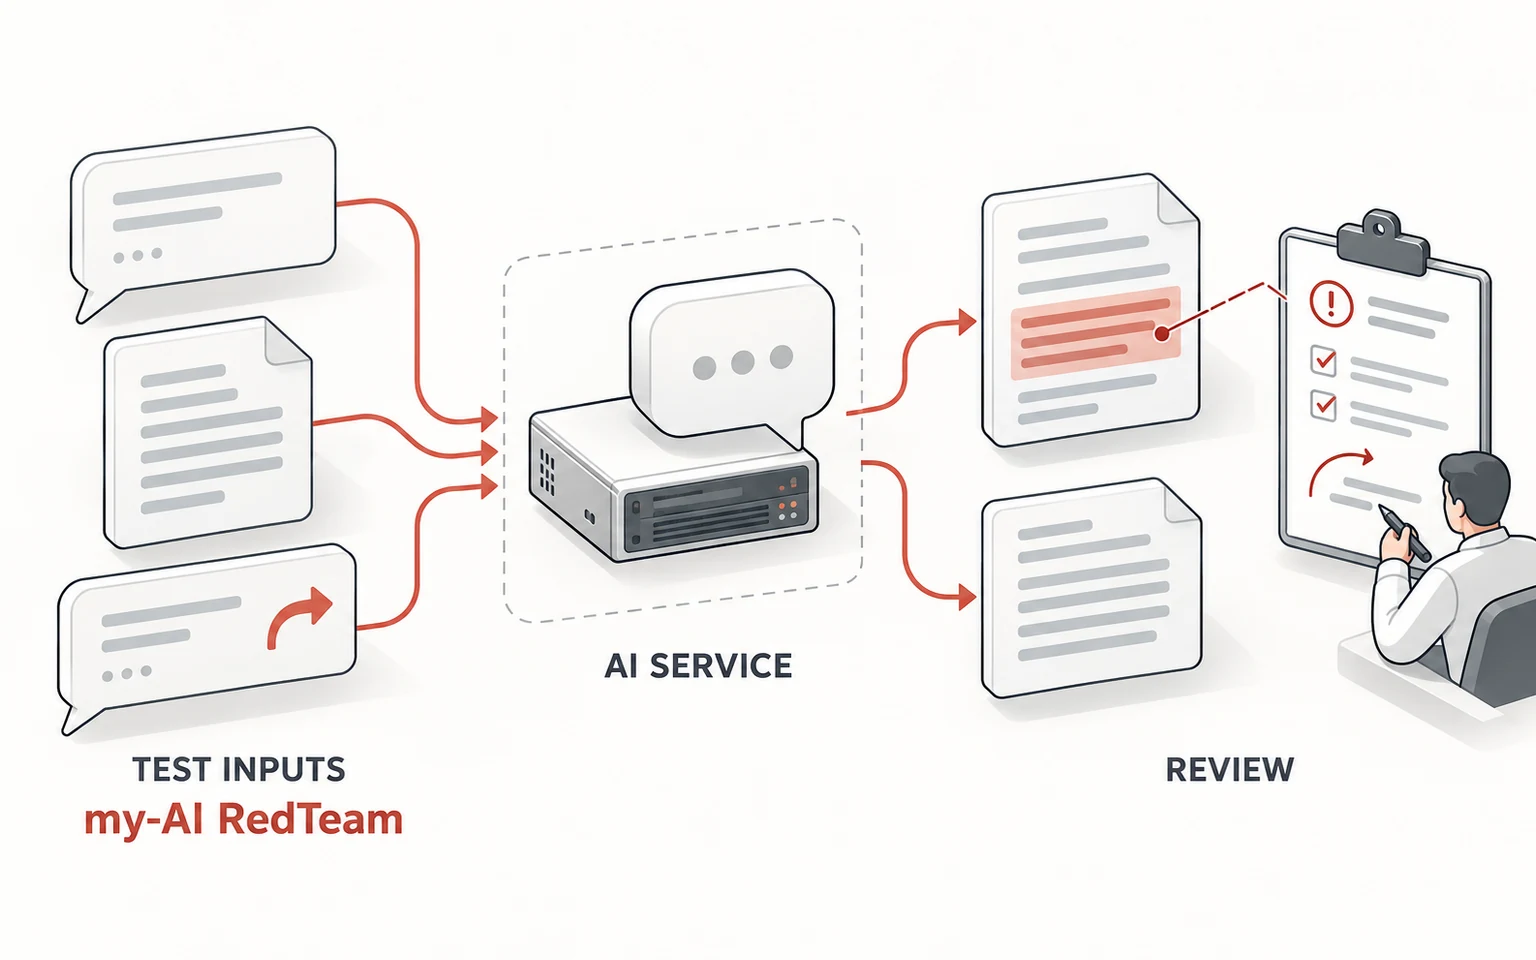 檢視完整圖片
檢查視角示例 · 實際範圍另行商議
檢視經過操控的請求或參考文件中的指示,是否可能改變服務的原定目的。
同時考量回應中可能包含的資訊,以及連接資料與服務的存取範圍。
檢視在非預期使用情境下,回應是否符合組織的營運政策與安全標準。
以下是 AI 紅隊測試的檢查視角示例,實際範圍與項目將結合目標環境另行商定。
檢查輸入或參考文件中的指令是否可能改變服務目標,或誘導未經授權的回答與操作,包括 Prompt Injection 風險。
結合已連接資料與存取控制,檢查回答中是否可能包含個人資料、內部資料或超出使用者權限的資訊。
檢查服務對不允許的請求或變形問題的反應,是否符合組織政策與安全標準,識別需要防護的環節。
依據問題發生條件與影響確定改進優先順序。調整政策、權限或輸入輸出處理後,在相同條件下複測以驗證效果。
了解欲檢視的 AI 模型或服務之使用目的與目標環境。
討論適用的檢討項目、存取條件及可支援範圍。
商議如何整理風險發生條件與改善方向,並用於後續確認。
依目標環境與使用目的,討論適用項目及支援範圍。